法律 RAG 检索的工程化:从单一策略失效到五段流水线
我们为一个覆盖 99 万条法规、3.2 万部法律法规文件的法律 AI 系统构建了检索层。这篇文章不是"我们用了什么技术栈"的介绍文,而是记录从单路检索失败到五段流水线成型的过程中,遇到的真实问题、走过的弯路、以及每个工程决策背后的理由。所有数据来自生产环境的 A/B 对照实验。
一、场景:法律检索和通用搜索的本质区别
先从一个真实场景说起。
律师问:"用人单位违法解除劳动合同,赔偿金怎么算?"
在通用搜索引擎里,返回任何讨论"劳动赔偿"的段落都算相关。但在法律场景里,用户的期望是精确命中《劳动合同法》第八十七条——这一条规定了"依照本法第四十七条规定的经济补偿标准的二倍向劳动者支付赔偿金"。返回第四十七条本身是"相关但不够好",返回其他法律里关于赔偿的段落则是"看似相关实则误导"。
这不是精度要求高低的问题,而是法律检索有三重通用搜索不面对的异质性。
第一重:语义-符号混合。法律查询同时包含自然语言意图("违法解除赔偿")和结构化引用("《劳动合同法》第八十七条")。向量检索擅长前者但丢失后者,关键词检索擅长后者但丢失前者。
第二重:权威层级。同一个法律问题,宪法、法律、行政法规、部门规章、地方性法规可能都有规定。律师引用时优先引上位法。两条同等相关的结果,权威等级高的应该排在前面。
第三重:时效版本。同一条法条可能同时存在"现行有效"、"已修改"、"已废止"、"尚未生效"四个版本。默认检索应该返回现行有效版本,但研究历史沿革时需要穿透版本链。
这三重异质性决定了:单一检索策略在法律场景注定有盲区,混合检索不是"锦上添花"而是"刚需"。
二、单一策略为什么失败
在用混合检索之前,我们分别用 BM25 和向量检索跑了同一批评测 query,观察各自的失败模式。
BM25 的失败:语义鸿沟。查询"劳动合同到期不续签的经济补偿",BM25 依赖关键词重叠。但《劳动合同法》第四十六条第(五)项的原文是"除用人单位维持或者提高劳动合同约定条件续订劳动合同,劳动者不同意续订的情形外,依照本法第四十四条第一项规定终止固定期限劳动合同的"——整段没有出现"到期"和"不续签"这两个查询关键词。BM25 把这条排在第 30 名开外。
向量检索的失败:精度坍塌。查询"十五日",向量检索基于 cosine 相似度。但"十五日"、"三十日"、"五日"在 1024 维空间里的距离差异极小——这些词共享大量上下文语义(都是时限、都出现在程序性条款里)。结果"十五日"查询把"三十日"和"五日"的条文都拉进 top-5,precision 暴跌。
关键发现:两条路的失败模式互补。BM25 丢的语义匹配,向量能捞回来;向量丢的精确匹配,BM25 能守住。这是混合检索有效的前提——如果两条路犯同一个错,融合毫无意义。
三、朴素混合为什么也不行
知道了单路不行,最直觉的方案是归一化加权融合:
<!-- 若站点不支持公式渲染,替换为图片: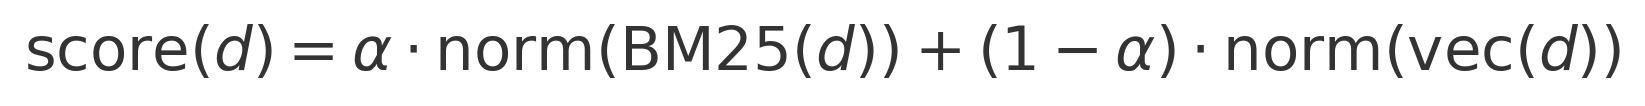 -->
这个方案看起来合理,但有三个工程上很难解决的问题。
问题一:分数空间不可比。BM25 的 _score 是 tf-idf 加权求和,范围 ,实际值通常在 5-50 之间(经验观察,量级随语料规模和实现而异);向量检索的 cosine similarity 范围 (归一化文本 embedding 实际多为 ,但数学上界仍为 )。归一化需要知道全局最大最小值,但 HNSW 近似索引返回的 top-k 只是局部采样——你拿到的最高分不代表全局最高分。用局部极值做归一化,换一批 query 就失效。
问题二:权重敏感。 取多少?换 embedding 模型要不要重新调?线性加权融合方案的已知问题是:一旦更换 embedding 模型或调整 BM25 参数, 就需要重新寻优。一个需要反复调参的融合方案,在语料库持续增长的系统里是不可维护的。
问题三:排序才是目标,分数只是手段。用户消费的是排序,不是分数。线性加权在分数空间操作,但分数差 0.001 的两条结果排名可能差 10 位。优化分数保序性,不如直接优化排名。
四、RRF:用排名代替分数
核心思想
Reciprocal Rank Fusion (RRF) 由 Cormack 等人在 2009 年 SIGIR 提出,核心思想极其简洁:不看分数,只看排名。
<!-- 若站点不支持公式渲染,替换为图片: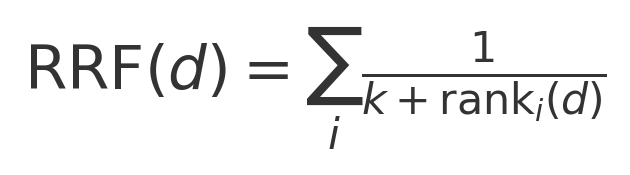 -->
其中 是文档 在第 条检索路中的排名(从 1 开始), 是平滑常数。
为什么 k=60
控制的是"头部优势"的衰减速度。
- 时:rank 1 得分 ,rank 2 得分 ,头部差距极大
- 时:rank 1 得分 ,rank 2 得分 ,头部差距缩小
- 时:rank 1 得分 ,rank 10 得分 ,rank 50 得分
的效果是:top-10 内的文档得分差异被压缩,排名靠后的文档逐步衰减但不会被压到零。这个值取自原论文的推荐取值,后被 Elasticsearch 等系统设为默认参数,在大多数混合检索场景下不需要调优——这恰恰解决了线性加权里 敏感的问题。
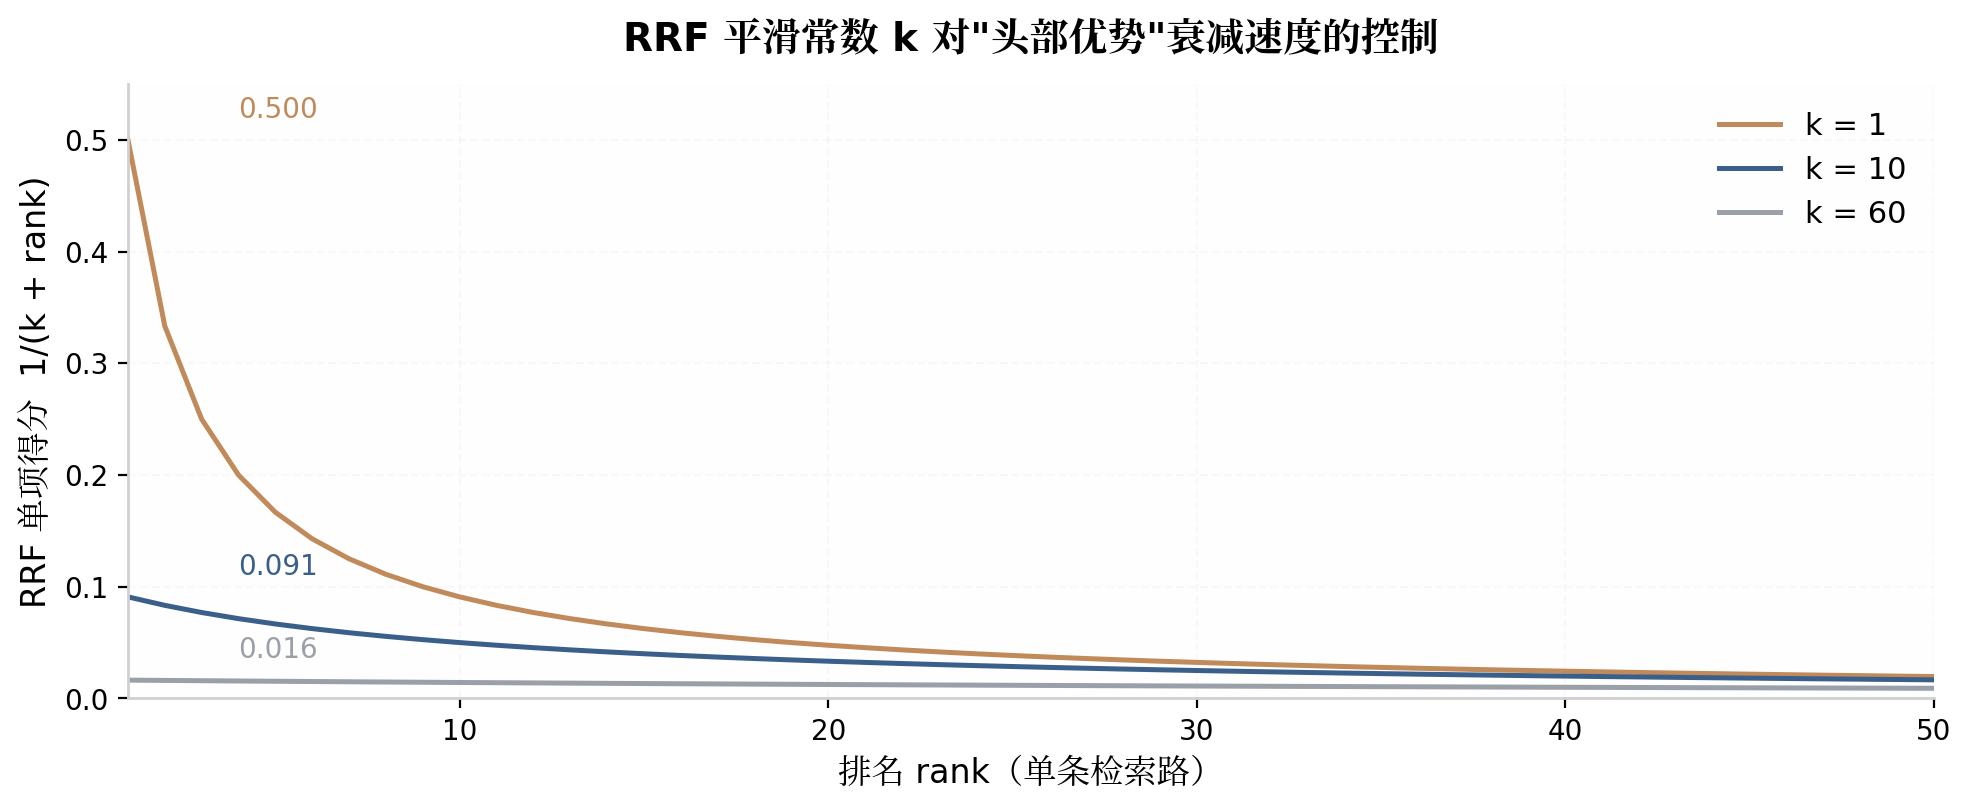
图:RRF 得分随排名的衰减曲线——k 越大,头部优势越平缓。
数值示例
假设一条法条在向量路排第 3,在 BM25 路排第 7:
<!-- 若站点不支持公式渲染,替换为图片: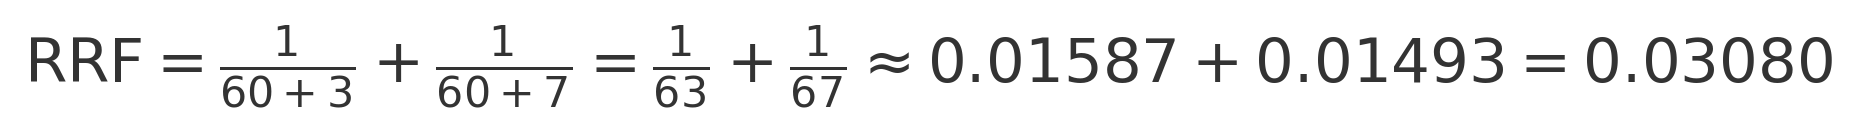 -->
如果另一条法条只在向量路排第 1,BM25 没命中:
<!-- 若站点不支持公式渲染,替换为图片: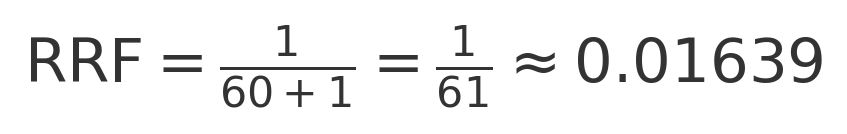 -->
两条路都命中的法条(0.0308)排在只一路命中的法条(0.0164)前面——"两路都认可"的文档自动上浮,不需要权重参数。
权威层级 tiebreaker
RRF 分数相同时怎么排序?这里用到法律场景特有的全序:权威层级。
我们的 tiebreaker 规则是:
- RRF 分数降序(主要排序)
- 权威等级升序(法律=1 优先于监管规则=5)
- articleKey 字典序(保证跨环境确定性)
第三条看似不起眼但很重要:同一个查询在开发环境和生产环境返回完全相同的排序,这是 A/B 评测可复现的基础。
五、中文法律的分词陷阱
RRF 解决了融合问题,但 BM25 路本身还有一个中文法律特有的坑。
嵌套形态族
Elasticsearch 的 IK 分词器有两种模式:
ik_max_word:最细粒度切分。"三十日"被切成"三十"、"十日"、"日"三个 tokenik_smart:最粗粒度切分。"三十日"作为整词保留
这在通用文本上只是粒度差异,但在法律时限词上会造成不对称召回。中国法律里的时限词——三日、五日、十日、十五日、三十日、六十日、九十日——构成一个嵌套形态族:它们互为子串,且各自代表独立的法律概念(诉讼时效、举证期限、上诉期限……)。
具体的失败场景:
| 查询 | 文档中的词 | ik_max_word 索引结果 | ik_smart 索引结果 |
|---|---|---|---|
| "十日" | "...三十日..." | ✓ 命中("十日"被切出) | ✗ 未命中(整词"三十日"≠"十日") |
| "五日" | "...三十日..." | ✗ 未命中(无"五日"子串) | ✗ 未命中 |
| "三十日" | "...三十日..." | ✓ 命中 | ✓ 命中 |
但“五日”查“三十日”会出现召回与精确不可兼得的困境:ik_max_word 索引下“十日”被切出,能召回“三十日”条文(精确度受损);ik_smart 索引下“十日”作为整词,无法匹配“三十日”(召回率受损)。单一配置无法同时解决两个方向的问题。
这不是边缘 case。时限类条文在中国法律中占比极高,且时限是否命中直接影响法律结论的正确性(诉讼时效过了就是过了,不存在"差不多")。
双字段方案
解法是对同一个文本字段建立两个不同粒度的索引,查询时同时打两个字段,取高分:
// 以下为索引配置示意,非实际代码
主字段:analyzer = ik_max_word(索引侧宽切分)
         search_analyzer = ik_smart(查询侧常规口径)
子字段 .smart:analyzer = ik_smart(索引侧粗切分)
              search_analyzer = ik_smart(查询侧粗切分)

查询:multi_match, type = best_fields
  字段 = [主字段, 子字段.smart]
  得分 = max(主字段得分, 子字段得分)
best_fields 模式取两侧分数的 max 而非 sum,避免同一个词在两个字段上重复计分。
这个方案有一个简洁的集合论保证:双字段的匹配集合是两种分词模式匹配集合的并集,因此召回率不低于任一单字段。best_fields 取两侧分数的 max 而非 sum,确保同一文档在两个字段上的得分不会被重复累加。代价是索引体积膨胀约 30%——对于我们的 99 万条法规规模,这是可接受的。
六、五段流水线:每一段解决一个失败模式
把上面的讨论组合起来,我们最终落地的是一条五段串行流水线。每一段不是"加一个组件",而是"解决前一段留下的一个失败模式":
查询 → [S1 元数据过滤] → [S2 BM25] + [S3 向量](并发)→ [S4 RRF 融合] → [S5 Rerank] → 结果

图:五段检索流水线——每一段解决前一段留下的一个失败模式。
Stage 1:元数据过滤 — 解决“时效版本”异质性
在检索之前,先按法规的时效状态、权威层级、地域范围过滤候选集。
一个实际的失败 case:查询“公司法股东回购”,如果不做时效过滤,2005 年版公司法的条文会混进来。这些条文已经被 2023 年修订版替代,条文编号和内容都变了。用户引用一条已废止的条文做法律意见,后果很严重。
默认过滤口径:
- 时效状态:排除“尚未生效”(已公布但未施行);“现行有效”和“已废止”均放行(时际法研究需求);已废止条文的排序由 reranker 自然降权
- 有效日期:排除
effective_date > today的行(2027 年施行的法条不能当现行法引用,与上条语义互补:状态字段标记版本生命周期,日期字段防止自然过渡前的误用) - OCR 质量和置信度:排除原始 OCR 未校正的低质量文本
调用方也可通过显式参数收紧口径(如仅返回“现行有效”),将时际法研究场景的默认宽松与生产场景的严格控制解耦。
Stage 2:BM25 关键词检索 — 解决"符号精确匹配"
使用前述双字段 IK 分词方案,top-50。擅长精确匹配法律名称、条文编号、专有术语。
Stage 3:向量语义检索 — 解决"语义泛化"
查询文本先过 embedding 模型生成 1024 维向量,然后在 pgvector HNSW 索引上做近似最近邻搜索,top-50。
向量相似度下限设为 0.35。这个值是保守的——HNSW 恒返回 top-k,即使最远的结果 cosine 只有 0.05,0.35 只切明显无关项。注意这个阈值是在结果侧做后过滤,不在 SQL 的 WHERE 条件里——因为 HNSW 索引下,SQL 端加 score 条件会导致索引失效退化为全表扫描,这是我们实测踩过的坑。
HNSW 参数选择 m=16, ef_construction=64,这是 pgvector 官方推荐的起步值。一个关键的工程经验:HNSW 索引必须在数据全部灌完之后再建。边灌边建会让导入速度慢 5-10 倍,因为每次插入都要更新图的邻接关系。
Stage 4:RRF 融合 — 解决"异构分数不可比"
如前文所述,k=60,权威层级 tiebreaker。融合后取 top-100 作为候选池。
两路检索通过 Promise.all 并发执行,总延迟取两路中最慢的那条。embedding 先行(串行),得到向量后再发起两路并发。
Stage 5:交叉编码器精排 — 解决“编码时不见面”的局限
前四段的 embedding 检索属于 bi-encoder 范式:query 和文档分别编码为向量,通过 cosine 距离排序——二者在编码时完全不见面,无法做 token 级的交互。交叉编码器(reranker)将 query 和单条文档拼接为同一输入序列,通过 Transformer 的全注意力机制做 token 级交互打分,精度显著更高但计算成本也更高,因此只用于精排。
精排模型有单次候选上限(50 条),超出部分不进精排。如果精排服务不可用(返回 null),系统静默退回到 RRF 排序,不报错、不阻塞——这是生产可用性的基本要求:一个辅助组件的故障不应该拖垮整个检索链路。
七、一个容易忽视的工程问题:向量同源
查询向量和库内向量必须来自同一个 embedding 模型,否则 cosine 相似度是噪声。
这不是理论风险。我们在切换 embedding 提供商的过程中,实际观测到同一查询"公司法·股份回购"从正确的结果跳到了"生态环境法典·土壤污染"——两个模型产生的向量空间完全不同,cosine 相似度跨模型无意义。
我们的解法是在检索前做一次同源校验:取库内有向量的行里占比最高的 embedding 提供商,与查询侧的提供商对比。不一致直接抛错,由上层决定降级策略。这个校验的开销是一次轻量聚合查询,可以忽略。
八、A/B 对照实验
实验设计
在 70 个标注查询的评测集上,我们跑了两组配置的完整对照:
- A 组(天翼云 AI 网关托管):通过天翼云 TokenHub 调用 text-embedding-v4 + qwen3-rerank(模型由阿里通义实验室提供,天翼云作为推理服务托管方)
- B 组(本地部署):BGE-M3 + bge-reranker-v2-m3
两组共用同一套 ES BM25 索引和 PG 数据库,仅 embedding 模型和 reranker 不同。
相关判定口径:法规名称子串命中 + 内容关键词包含(若评测用例指定了 contentAny)。这是宽松口径,可能高估 recall,但对两组公平。
核心指标
| 指标 | A 组(天翼云) | B 组(本地) | 差距 |
|---|---|---|---|
| Recall@10 | 100% | 98.6% | +1.4pp |
| MRR | 0.940 | 0.908 | +0.032 |
| Hit@3 | 98.6% | 92.9% | +5.7pp |
| p50 延迟 | ~300ms | ~2000ms | 6.7x |
| p95 延迟 | 902ms | 7187ms | 8.0x |
口径说明:Recall@10=100% 基于 70 条宽松口径评测集(法规名子串 + 关键词命中),无 hard negative 对抗样本。这一数字的信息量低于其视觉冲击力,详见第十节局限二。
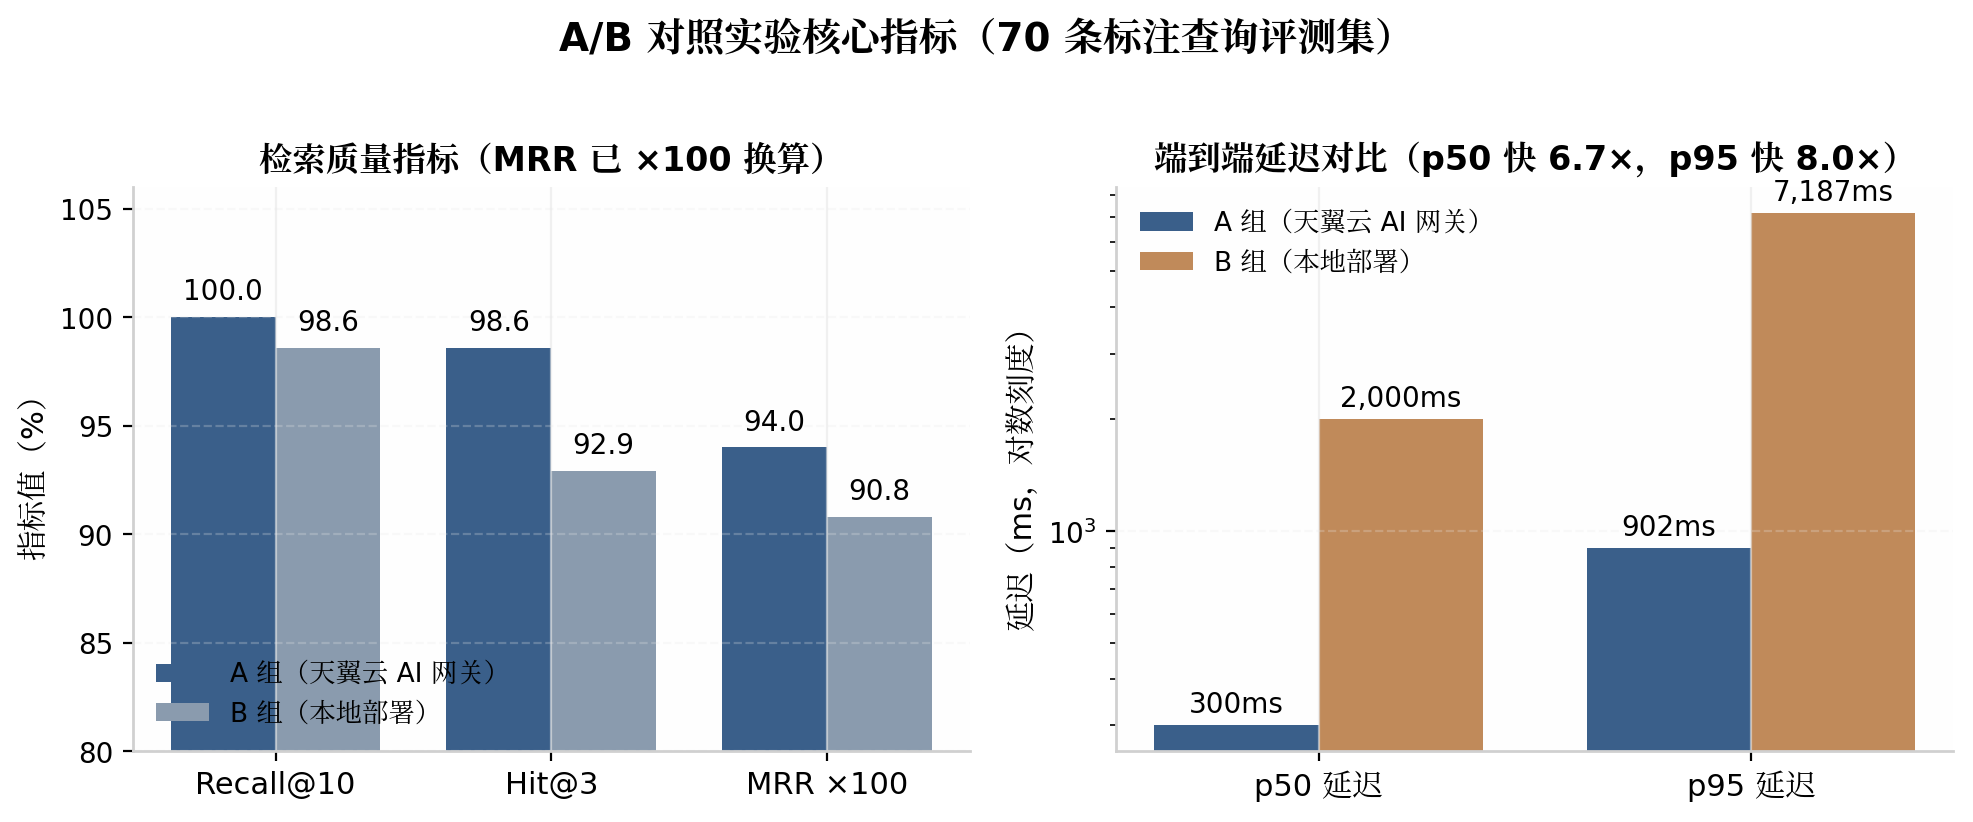
图:A 组(天翼云托管)与 B 组(本地部署)的核心指标对照。
延迟分解
一条典型查询的端到端延迟分布(A 组天翼云,p50 口径):
| 阶段 | 延迟 | 占比 |
|---|---|---|
| Embedding 生成 | ~80ms | ~27% |
| 向量检索(PG HNSW) | ~30ms | ~10% |
| BM25 检索(ES) | ~40ms | ~13% |
| RRF 融合 | <1ms | <1% |
| Rerank 精排 | ~150ms | ~50% |
| 总计 | ~300ms | 100% |
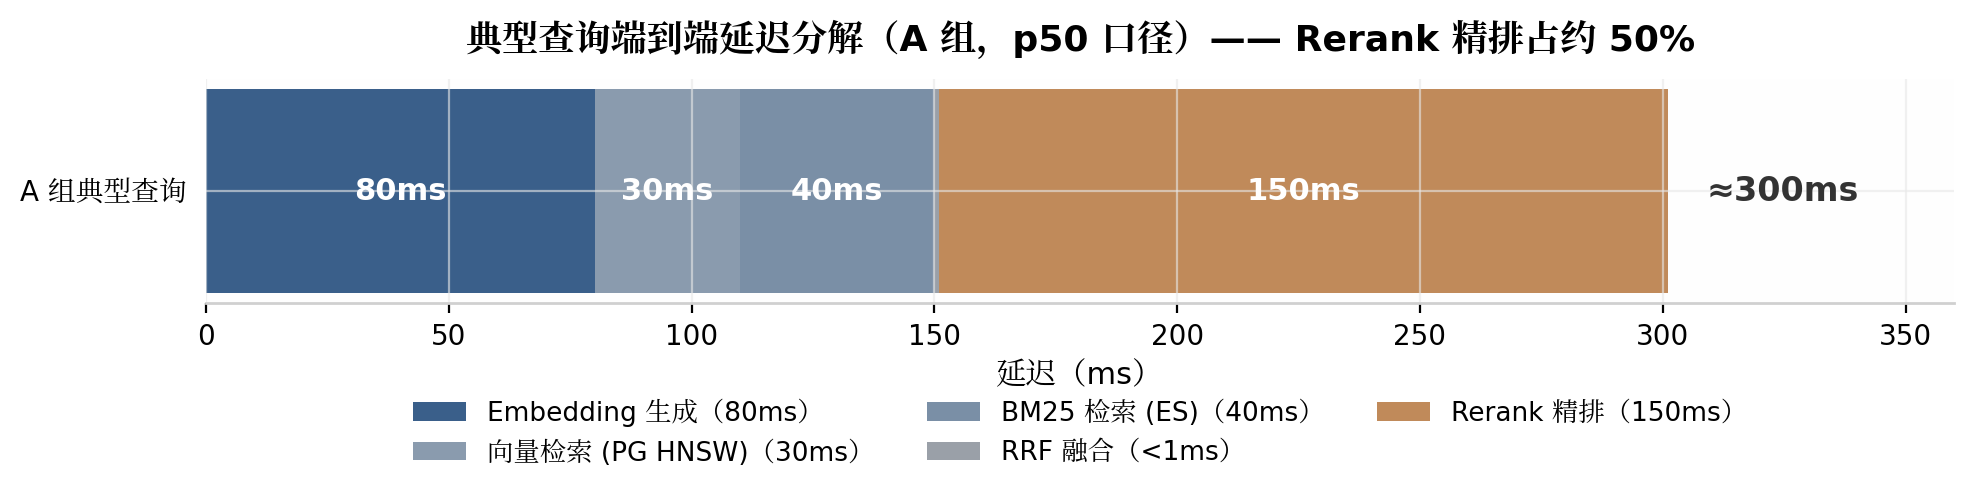
图:A 组典型查询的端到端延迟分解——Reranker 占约 50%。
Reranker 是整条链路的主要延迟来源,占约 50%。这也解释了为什么 Stage 5 的静默降级机制很重要——如果 reranker 超时,总延迟可以从 300ms 降到 150ms,代价是从交叉编码器精排退化到 RRF 排序。
一条查询的完整 trace
以查询"用人单位违法解除劳动合同赔偿金计算标准"为例(A 组):
- Embedding:80ms,生成 1024 维向量
- 向量路 top-50:30ms,返回 50 条候选,最高 cosine=0.82(《劳动合同法》第八十七条),最低 cosine=0.41(被 0.35 阈值过滤掉 8 条,保留 42 条)
- BM25 路 top-50:40ms,返回 50 条候选,最高分来自《劳动合同法》第四十七条(包含"经济补偿"关键词)
- RRF 融合:<1ms,第八十七条两路都命中(向量路 rank 1、BM25 路 rank 5),RRF = 1/61 + 1/65 ≈ 0.0318;第四十七条仅 BM25 命中(rank 2),RRF = 1/62 ≈ 0.0161。第八十七条排在第一位
- Rerank:150ms,从融合后 top-50 中精排出 top-20,第八十七条仍为 rank 1,relevance=0.91
最终返回:《劳动合同法》第八十七条(rank 1)、第四十七条(rank 2)、《劳动合同法实施条例》第二十五条(rank 3)。
九、与同行方案的比较
我们不是第一个做法律 RAG 检索的。把主要参照物放在同一个坐标系里:
Anthropic Contextual Retrieval (2024):给每个 chunk 加文档级上下文前缀再 embedding,结合 BM25 + embedding 双路 + RRF 融合。我们的 encoded_text 前缀化设计直接受此启发。但 Anthropic 的方案是通用的两路融合,没有元数据过滤(Stage 1)、没有权威层级 tiebreaker。精排在 Anthropic 方案中作为可选组件存在(加 rerank 后 top-20 失败率降低 67%),而非核心贡献。
SAG (Zleap AI, 2026):用 event-entity 索引替代全局知识图谱,查询时通过 SQL join 动态扩展。SAG 在通用多跳 QA 上(MuSiQue/HotpotQA)全面超越 GraphRAG 类方法,Recall@5 达 80.36%。SAG 论文自认的两个局限——alias disambiguation 和 temporal updates——恰好是我们的已解决问题(法名归一和版本仲裁)。但 SAG 解决的多跳推理问题,我们的单跳流水线不处理。
LegalBench-RAG (2024):首个专为法律 RAG 设计的检索评测基准,覆盖英文法律的合同条款定位和法条引用场景。我们的评测集设计参考了其方法论,但面向中文法律,且额外包含时效状态和权威层级两个评测维度。
LegalRAG (2025):多语言法律混合检索,实现了 BM25 + dense + rerank 三阶段流水线。与我们的方案最接近,但未做中文法律特化(无 IK 分词处理、无权威层级排序、无版本管理)。
ChatLaw / DISC-LawLLM (2023):中国法律大模型路线,通过 fine-tuning 或向量库减少幻觉。2026 年 Springer 论文指出 ChatLaw 用向量库减少幻觉但无法保证时效性、DISC-LawLLM 依赖 SFT 但检索能力有限。我们选择 RAG 路线而非 fine-tuning 路线,核心原因是法规库需要实时更新——新法公布到系统可用应该在小时级而非月级。
我们的定位:不是提出新的检索算法,而是把已有算法(RRF、BM25、HNSW、cross-encoder)针对法律领域的三重异质性做端到端的工程化整合。增量贡献在于:(1) 权威层级感知的 tiebreaker;(2) 中文法律时限词的双字段 IK 方案;(3) 版本仲裁和时效过滤的元数据层设计;(4) 向量同源校验的工程可靠性。
十、局限性:我们知道哪些没解决
诚实列出当前方案的局限,每条附一个具体的失败 case:
局限一:只做单跳检索。当前的评测是"一个查询 → 命中目标条文"。但很多法律问题需要多跳推理——"A 法引用了 B 法第 X 条,B 法第 X 条又被 C 司法解释细化,C 司法解释在 D 案例中被最高法适用"。这需要知识图谱辅助的多跳遍历,当前检索层不处理。
失败 case:查询"民法典合同编通则司法解释中关于违约金调整的裁判规则",需要先从民法典跳到合同编通则司法解释,再从司法解释跳到具体裁判规则。当前系统只能命中司法解释本身,无法自动串联裁判规则。
局限二:评测集缺乏 hard negative。当前 70 条评测集以"能不能找到目标条文"为主,缺少"看起来很像但不是"的对抗性样本。例如查询"劳动者提前三十日通知解除劳动合同",《劳动合同法》第三十七条(劳动者单方解除)是正确答案,但第三十八条(用人单位过错下的即时解除)和第四十六条(经济补偿情形)看起来也很像。当前评测集没有刻意构造这类 hard negative,recall 指标可能高估了对抗性场景下的表现。
局限三:IK 分词只覆盖了时限词。法律中文还有其他 NLP 难题没有解决——法律简称("消法"=消费者权益保护法、"刑九"=刑法修正案九)、条文合并(旧法三条合并为新法一条时的 articleKey 映射)、同形异义("管辖"在民事诉讼和刑事诉讼中的含义差异)。双字段 IK 只解决了时限词这一个子问题。
局限四:Reranker 外部依赖。精排模型通过天翼云 AI 网关调用 qwen3-rerank(阿里通义模型),延迟约 150ms,是整条链路最大的延迟来源。本地部署的 bge-reranker-v2-m3 延迟低但 hit@3 差 5.7 个百分点。在完全离线部署的场景下,精度和延迟之间需要取舍。
总结
| 工程决策 | 选择 | 解决什么问题 |
|---|---|---|
| 融合算法 | RRF (k=60) | 异构分数空间直接混算,无需归一化调参 |
| 中文分词 | IK 双字段 + best_fields | 法律时限词嵌套形态族的不对称召回 |
| 排序 tiebreaker | 权威层级 → articleKey 字典序 | 法律上位法优先 + 跨环境确定性 |
| 元数据过滤 | 检索前硬过滤时效/质量 | 未生效法条污染结果,已废止条文由 reranker 降权 |
| 精排 | 交叉编码器 + 静默降级 | bi-encoder 编码时不见面 + 服务可用性 |
| 向量校验 | 同源检查 | 跨模型向量空间的语义漂移 |
| 生产选型 | 天翼云 AI 网关托管 | A/B 数据全面优于本地,p95 延迟快 8 倍 |
这套方案已经在生产环境运行,日均服务数千次法律检索请求。它不是学术上最前沿的检索架构,但可能是目前中文法律 RAG 场景下工程化最完整的方案之一。
如果这篇对你在做法律、合规、监管或金融领域的 RAG 系统有参考价值,欢迎交流。后续计划写法律知识图谱构建和防幻觉校验两篇。
参考文献
- Cormack, Clarke, Büttcher. "Reciprocal Rank Fusion outperforms Condorcet and individual Rank Learning Methods." SIGIR 2009. DOI: 10.1145/1571941.1572114
- Anthropic. "Introducing Contextual Retrieval." Anthropic Engineering Blog, September 2024. https://www.anthropic.com/engineering/contextual-retrieval
- Wu et al. "SAG: SQL-Retrieval Augmented Generation with Query-Time Dynamic Hyperedges." arXiv:2606.15971, 2026.
- Pipitone, Alami et al. "LegalBench-RAG: A Benchmark for Retrieval-Augmented Generation in the Legal Domain." arXiv:2408.10343, 2024.
- Park, Oh et al. "LRAGE: Legal Retrieval Augmented Generation Evaluation Tool." arXiv:2504.01840, 2025.——法律 RAG 全链路评测工具,与本工作评测集设计方法论同源。
- Kabir et al. "LegalRAG: A Hybrid RAG System for Multilingual Legal Information Retrieval." IJCNN 2025. arXiv:2504.16121.
- Liu, Liu et al. "The trade-off between robustness and reliability in Chinese legal large language models: an empirical study." Artificial Intelligence and Law, Springer, 2026. DOI: 10.1007/s10506-026-09510-z