法律 AI 多 Agent 协作:结构化信封协议与质量门防幻觉实践
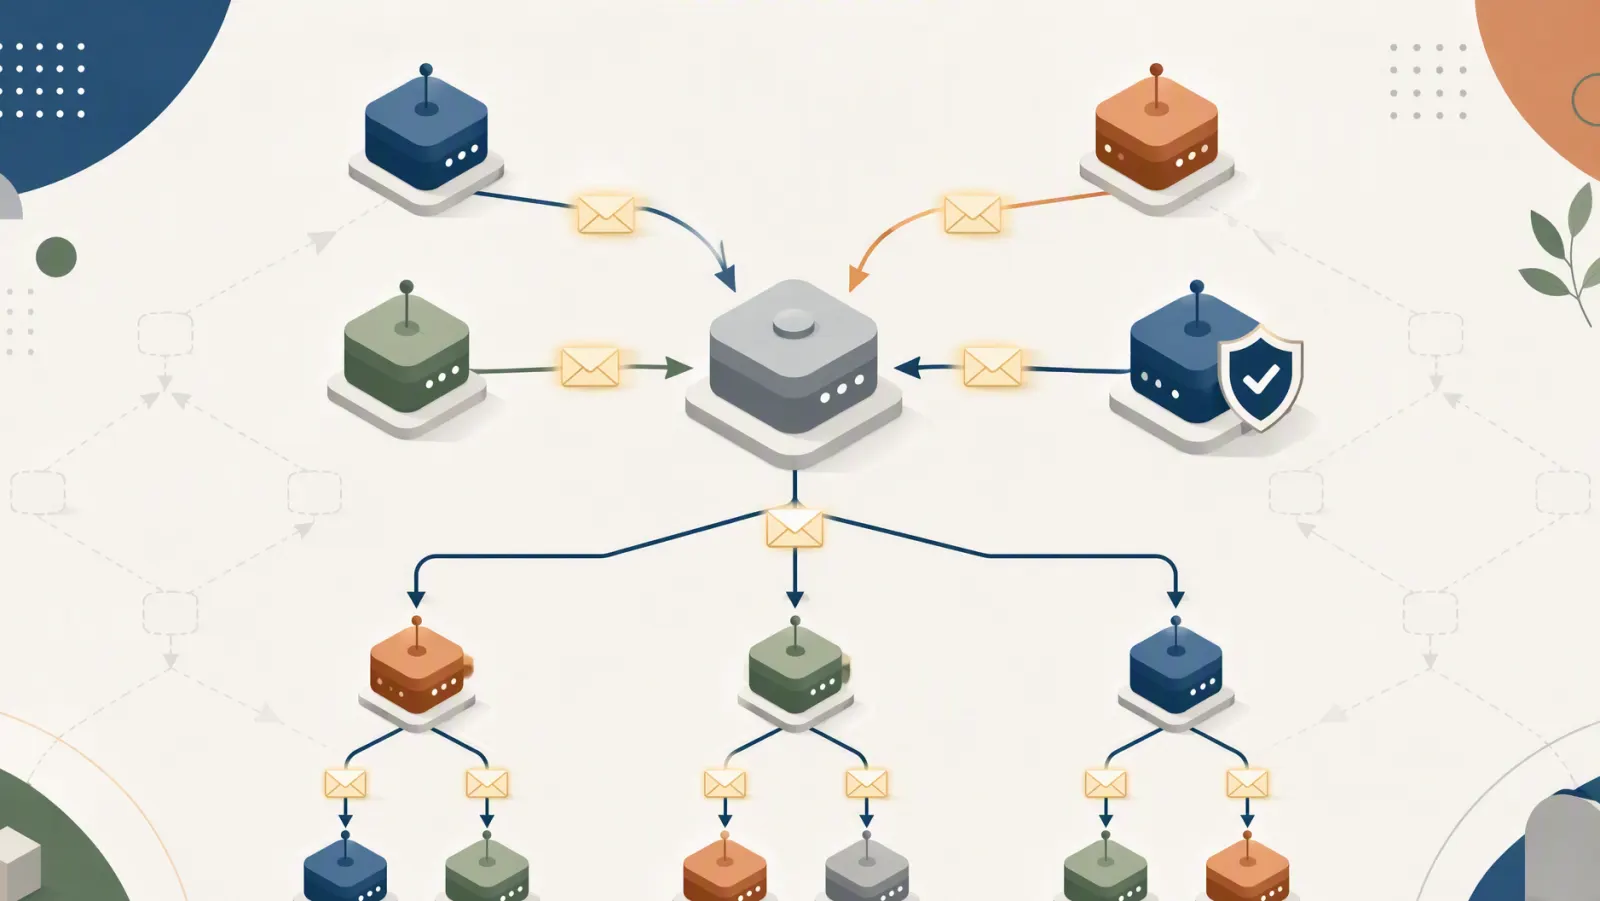
在金融、医疗、法律这类严肃决策领域,单模型推理正在逼近其结构天花板。本文记录我们为法律 AI 系统设计的一套多 Agent 协作协议——ASEP(Agent Structured Envelope Protocol)。四个 Agent(研究员、分析师、起草员、复核员)通过结构化信封传递结果,而非互传自由文本。文章先讨论多 Agent 在这些领域的必要性,再展开协议的设计原理、多场景应用和生产环境表现。
一、为什么严肃场景更需要多 Agent 协同
当前法律 AI 的主流做法是把一个足够强的大模型(如 DeepSeek-R1、Moonshot k1.5、GPT-4o 等)直接用于法律推理——给一个法律问题,模型输出一段包含分析过程的完整回答。这类"单模型 + 思维链(CoT)"方案在标准化推理测试上表现出色(如 DeepSeek-R1 在 AIME 2024 多步数学推理基准上达到 79.8% pass@1,与 OpenAI o1 相当),但在真实法律实务中遇到了结构性瓶颈。
一个典型场景:交叉争议点的案卷需要四跳推理(事实认定 → 要件匹配 → 法条援引 → 后果推导)。我们在实测中观察到,推理链越长,中间环节的置信度下降越明显——这与 RLM 论文(Zhang et al., 2025)对长上下文递归推理的观察一致。这不是某个模型的能力天花板,而是单模型结构的固有局限:一条连续的 CoT 链越长,中间任何一个环节的错误就越容易累积到最终结论。
这个局限在法律、金融、医疗等严肃决策领域被显著放大:
错误不可隔离。单模型的一段输出里,事实认定、法律适用、结论推导混在一起。如果第三步引用的法条有误,整个推理链都要推翻重来,但你无法只重跑第三步——因为它是连续 CoT 的一部分,没有结构化的步骤边界。
过程不可审计。法官质询"你的第三跳依据是哪条数据",单模型无法回答——它只有一段 CoT 文本。在司法实践中,等保三级(GB/T 22239)要求系统运维层面的操作日志留存与审计。我们将这一合规思路延伸到 AI 推理场景:推理链路也应做到逐跳可追溯——这不是等保原文要求,而是我们对合规精神的主动对齐
审查者与被审查者同质。让同一个模型检查自己的输出(self-consistency),幻觉检出率显著低于异质审查——用一个符号校验 Agent(SRE)审查另一个推理 Agent 的信封,检出率要高得多。因为审查者不需要"理解"推理过程,只需要用符号规则验证信封中的结构化字段。
这三条不是"多 Agent 更好"的优势论据,而是"单模型做不到"的结构性缺口。多 Agent 协同的增量价值在于四个正交维度:
| 维度 | 单模型做不到 | 多 Agent 怎么做 |
|---|---|---|
| 错误隔离 | CoT 链无步骤边界,一个错误污染全链 | 步骤间用信封传递,错误在第 N 跳被熔断,不回溯也不扩散 |
| 上下文外置 | 所有中间状态挤在一个 prompt 里 | 中间结果外置为信封,模型只收 metadata 不收原文 |
| 可审计性 | 一段 CoT 无法回答"第 3 跳依据什么" | 信封链留痕:session_id + hop_seq + hash,全链可重建 |
| 元级审查 | 自检 = 同质审查,幻觉检出率低 | SRE 用符号规则(非 LLM)审推理信封,异质审查 |
二、多 Agent 自由协作为什么也会失控
多 Agent 是必要的,但简单地让多个 Agent 协作并不能解决问题。早期版本里,Agent 之间传递的是自由文本(上一个 Agent 的完整输出直接塞进下一个 Agent 的 prompt)。这导致了三个新问题:
问题一:上下文爆炸。研究员的完整检索报告可能有 8000 tokens,分析师的风险评估 5000 tokens,全部堆进起草员的 prompt 就是 13000 tokens 的前置上下文。加上起草员自己要生成的 3000+ tokens 合同正文,再加上复核员又要把全文传给自己的 prompt——一次完整的四步协作累计消耗超过 40000 tokens。这还只是一个简单的合同,复杂场景下轻松突破 100K。
问题二:结构漂移。起草员被要求输出"合同条款清单",但因为没有结构约束,它可能输出"合同概述 + 条款清单 + 补充说明 + 风险提示"。下游复核员拿到的不是预期的结构化条款列表,而是一篇散文——复核逻辑无法按条款逐条校验,只能做整体性检查,漏检率极高。
问题三:质量无法路由。复核员发现"第三条引用的法条号不存在",但它只能返回一段自然语言"建议检查第三条引用"。上游起草员收到这段话后,可能修改第三条,也可能修改其他条款——因为没有结构化的"定向修改指令",修复变成了随机尝试。
这三个问题的共同根因是:Agent 间的通信缺乏结构化契约。自由文本是 LLM 最擅长的输入输出格式,但它不是机器可路由、可截断、可校验的格式。
三、核心原理:骨架-载荷分离
ASEP(Agent Structured Envelope Protocol)的核心思想可以用一句话概括:把每次 Agent 输出拆成"骨架"和"载荷"两部分,骨架是机器可解析的结构化元数据,载荷是自然语言正文。
用一个类比:传统 HTTP 协议的 Header + Body 分离。Header 是路由器看的(Content-Type、Status-Code),Body 是应用层消费的内容。ASEP 的信封之于 Agent 输出,正如 HTTP Header 之于 HTTP 响应。
形式化定义
定义 1(信封):一次 Agent 输出 被映射为一个信封 ,其中:
- (骨架/Skeleton)= ——机器可解析的元数据元组
- (载荷/Payload)= 自然语言正文,LLM 最擅长处理的格式
骨架和载荷有一个根本性的不对称:骨架永不截断,载荷可按预算截断。
这个设计基于一个经验观察:在下游 Agent 的 prompt 中,载荷(正文)是 token 消耗的主要来源,而路由决策主要依赖骨架(状态、置信度、关键交付物)。截断载荷可以大幅节省 token 而不影响路由决策的正确性。
一个实际的信封结构(示意,字段已简化):
// 以下为信封 JSON schema 示意,非实际代码
{
  "env_ver": "1.2",
  "envelope_id": "env_20260914_a3f2",
  "session_id": "sess_8k2m",
  "hop_seq": 3,
  "sender": { "agent_id": "researcher", "model": "deepseek-r1" },
  "status": "success",
  "confidence": 0.82,
  "key_deliverables": ["劳动合同法第87条适用", "赔偿金二倍标准"],
  "output_files": ["s3://reports/labor-dispute-analysis.md"],
  "handoff_notes": ["重点关注赔偿金与经济补偿的关系"],
  "content": "...自然语言正文...",
  "legal_meta": {
    "law_name": "劳动合同法",
    "article_no": "87",
    "efficacy": "active"
  }
}
信封协议包含版本号(env_ver)以便向前兼容;每次传递携带会话 ID 和跳序号,支持全链审计重建。
骨架不变性
骨架中有一类特殊字段——结构化块(如 SUGGESTIONS、SCAN、RISK_POINTS)——它们是 Agent 产出的结构化结论,格式固定、语义完整。对这类块,我们定义一个不变性约束:
<!-- 若站点不支持公式渲染,替换为图片: -->
即无论 token 预算多紧张,结构化块永远不会被截断。自然语言正文是第一个被截断的对象,结构化块是最后一个。
实际效果:一份 8000 tokens 的研究报告,在 compact 模式下压缩到约 3200 tokens(节省 60%),但所有结构化结论(风险点列表、法条引用列表、关键交付物清单)一字不少。
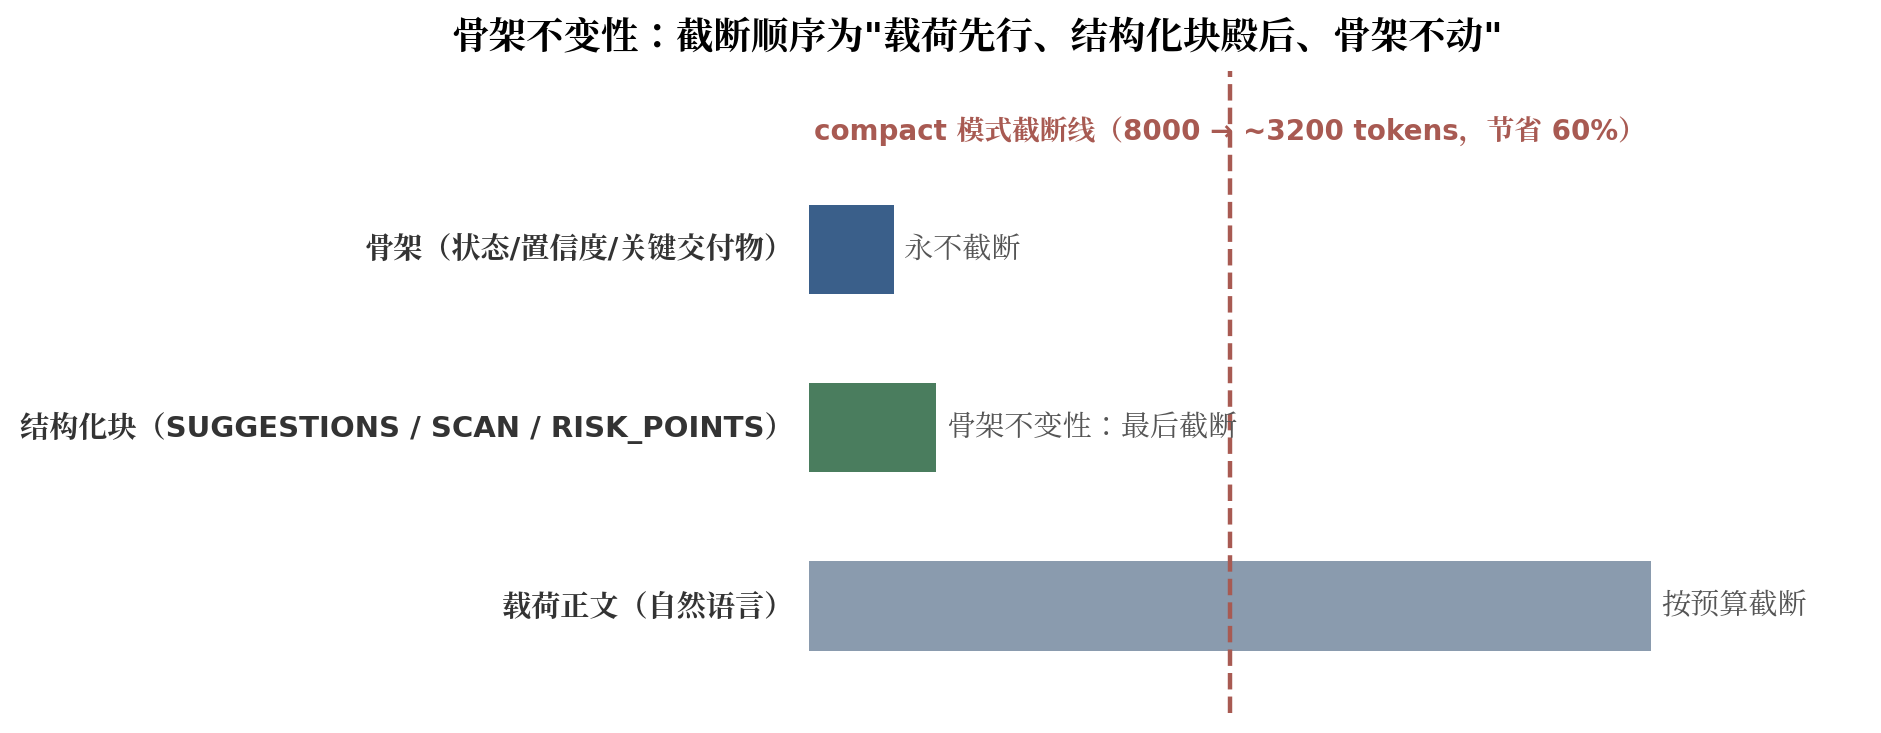
图:compact 模式下的 token 预算分配——载荷被截断,骨架与结构化块完整保留。
四、信封的生命周期
一个信封从产生到被下游消费,经历四个阶段:
4.1 打包(Pack)
Agent 完成推理后,原始输出被解析为标准信封。解析过程提取:
- 文件路径(
output_files)——正则匹配.pdf.docx.md等路径 - 关键交付物(
key_deliverables)——从输出中提取要点,限制最多 8 项(经验上限,平衡信息密度与 prompt 长度),每项最多 80 字 - 交接备注(
handoff_notes)——最多 6 条(经验上限),每条最多 120 字 - 置信度(
confidence)——0 到 1 之间的浮点数
置信度的初始估算采用启发式规则(基础分 + 增量调整):任务失败=0.2,有文件产出 +0.2,正文超过 500 字 +0.1,超过 2000 字 +0.1,包含失败关键词 -0.15。这套启发式是轻量级的粗筛信号,用于第五节的三级路由(快速决定中间结果是否进入下游);真正的交付质量评估由第七节的质量门负责——后者采用四信号加权评分,与启发式置信度是两套独立的评估体系。
4.2 解包(Unpack)
下游 Agent 消费信封时,骨架和载荷被重新渲染为 prompt 文本段。两种格式:
标准格式(unpackEnvelope):完整呈现骨架元数据和载荷正文,适合直接下游消费。
紧凑格式(unpackCompact):一行式编码,形如:
// 以下为格式示意,非实际代码
[研究员|法律检索|OK] D:劳动合同法第87条;经济补偿金计算标准|F:report.md|N:重点关注赔偿金二倍标准
这种格式与标准格式相比可节省约 60% 的 token(实测数据,与第三节 compact 模式节省率一致),适合在聚合多个信封时使用——当四个上游 Agent 的信封同时塞进起草员的 prompt 时,节省的 token 量级是显著的。
4.3 聚合(Aggregate)
当一个步骤依赖多个上游步骤时(如起草员依赖研究员 + 分析师),多个信封被聚合为统一的 prompt 片段。聚合器自动按信封数量分配 token 预算——如果总预算 8000 tokens、有 2 个上游信封,每个分到 4000 tokens。载荷超出预算的部分被截断,骨架完整保留。
4.4 传递(Handoff)
信封通过 DAG 工作流的步骤间传递。每个步骤的输出信封被注册到工作流上下文中,下游步骤通过依赖声明引用上游信封。这形成了一个有向无环图的信息流:
意图路由 → 研究员(research) → 分析师(analyst)
                               ↓           ↓
                           起草员(drafter) → 复核员(reviewer) → 聚合输出

图:信封驱动的 DAG 信息流——研究员与分析师并行,起草员扇入,复核员收口。
研究员和分析师可以并行执行(无依赖,总延迟取两路中最慢的),起草员等待两者完成后再执行,复核员等待起草员完成。
五、置信度驱动的三级路由
信封中的 confidence 字段不是装饰——它驱动下游的三级决策:
| 置信度范围 | 决策 | 含义 |
|---|---|---|
| ≥ 0.8 | pass | 质量可信,直接传递给下游 |
| 0.5 – 0.8 | degrade | 降级使用:保留骨架,载荷标记为"待验证" |
| < 0.5 | block | 阻断:该 Agent 的输出不进入下游,触发重跑或升级 |
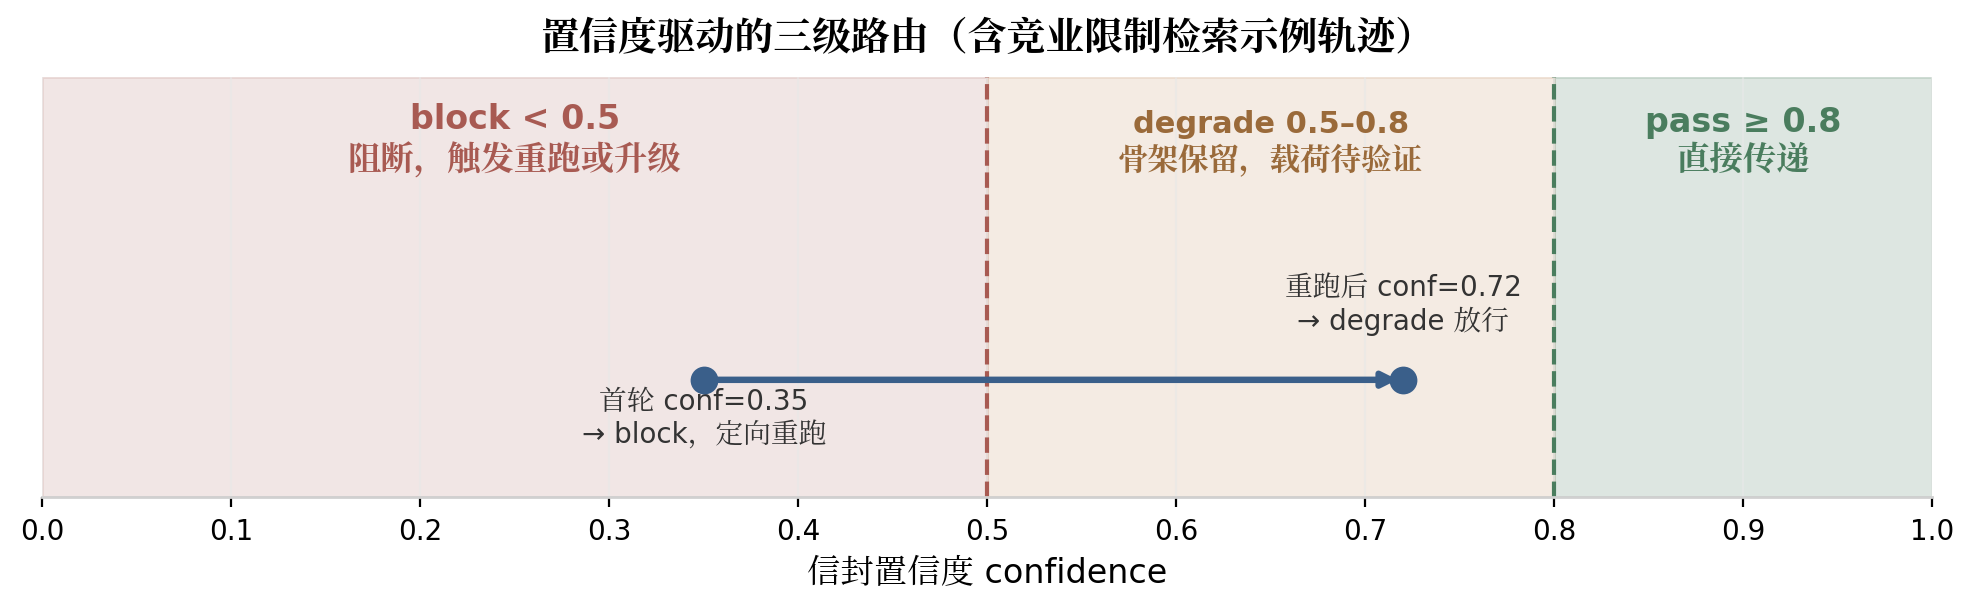
图:置信度三级路由——pass / degrade / block 的决策区间与处理路径。
一个示意性的路由场景
研究员检索"竞业限制违约金上限",返回 confidence=0.35(检索结果不够精确)。三级路由做出 block 决策:
- 研究员的输出不进入起草员的 prompt
- 系统触发一次定向重跑,注入提示:"上次检索结果精度不足,请限定在《劳动合同法》第二十三、二十四条范围内"
- 重跑后 confidence=0.72 → degrade:骨架(关键法条引用)传递给起草员,但标注"来源待复核"
- 复核员在最终校验时重点审查这部分内容
这个机制的核心价值是:质量信号在步骤间显式传递,而非等到最终才发现中间环节出了问题。传统做法是等整个流水线跑完再整体评估,发现问题后只能从头重跑。ASEP 在每一步都有质量检查点,问题在发生的环节就被捕获。
意图路由:快速路径 + LLM 兜底
在流水线入口处,意图路由器也采用类似的置信度门控。它的双路策略是:
- 快速路径(< 50ms):按关键词词表匹配,确定性判定,不调用 LLM。如用户说"起草合同"直接路由到合同起草流程
- LLM 路径(~1s):快速路径置信度 < 0.8 时,调 LLM 做语义判断
工程护栏(clampAction)在路由出口统一收口:合同审查必须有上传材料、企业调查仅特定版本可用、诉讼分析仅法律版可用。这些护栏是硬约束,不受置信度影响。
六、范式库:两态审定分级
ASEP 在法律合同场景有一个特殊应用:范式库(Pattern Library)。
范式库是一个结构化的条款模板库,每条条款模板有一个审定状态:
| 状态 | 含义 | 处理方式 |
|---|---|---|
lawyer-verified | 律师审定过的条款 | 逐字直出,不经 LLM 生成 |
ai-draft | AI 生成或聚类产出的条款 | 进 LLM 生成组,以范式为措辞锚点 |
这个设计的逻辑是:律师审定过的条款措辞是法律上的"安全港"——它们在法律上被验证过,逐字使用不会引入措辞风险。LLM 生成的措辞即使语义正确,也可能在关键术语上出现微妙偏差("应当"vs"可以"、"连带责任"vs"补充责任")。
组装流程
合同组装分为两个阶段:
阶段 1:纯函数组装(零 LLM)
给定法律关系(如"软件开发")、立场(甲方/乙方)、行业(IT),组装引擎通过以下规则决定合同条款结构:
dependsOn:前置条款自动补全(选了"违约金条款"自动补"违约责任条款")conflictsWith:互斥条款裁决("固定价格"和"工时计费"不能同时出现)requiresOneOf:二选一补全("争议解决"必须在"仲裁"和"诉讼"中选一个)
这一步是纯函数——相同的输入永远产生相同的条款结构,没有 LLM 参与,没有随机性。
阶段 2:LLM 生成
lawyer-verified 条款逐字直出,ai-draft 条款进入 LLM 生成组。生成时,范式模板作为措辞骨架,LLM 只在槽位内填充具体业务信息。生成并发上限 20 条,每条温度 0.1(低随机性)。
每条生成完后过要素回扫(element-check):拿范式母结构中的必备要素清单核对生成文本,未落地的要素定向回炉重写。
必备级别的三档设计
每个条款模板有一个必备级别:
legal-mandatory(法定记载事项):缺失则硬拦截,合同不合格structural-required(结构必需):缺失则提示,可人工决定跳过optional(可选):不强制
法定必备条款的检查基于词表规则,零幻觉风险。这是"让机器做机器擅长的事"的一个实例:判断"这份合同有没有仲裁条款"是简单的结构匹配,不需要 LLM。
七、质量门:四信号加权评估
流水线末端的质量门是整个系统最关键的组件。它回答一个问题:这次协作的产出是否达到了交付标准?
四个可验证信号
| 信号 | 权重 | 验证方式 |
|---|---|---|
| consistency(一致性) | 0.30 | 复核员 vs 起草员结论交叉比对,结构化冲突检测 |
| rubric(质量标准) | 0.45 | LLM 自评是否达到预设质量标准,逐项 pass/fail |
| citation(引用可核验率) | 0.25 | 引用的法条号在法规库中查库验证 |
| coverage(论断覆盖率) | 0.20 | 论断-引用配对计数 |
权重之和 = 0.30 + 0.45 + 0.25 + 0.20 = 1.20,超过 1 是故意的——当某个维度不适用时(如没有引用的任务不计 citation),该维度权重不参与归一化,其余维度按比例放大。这保证了有引用维度的任务比没有的任务受到更严格的检查。
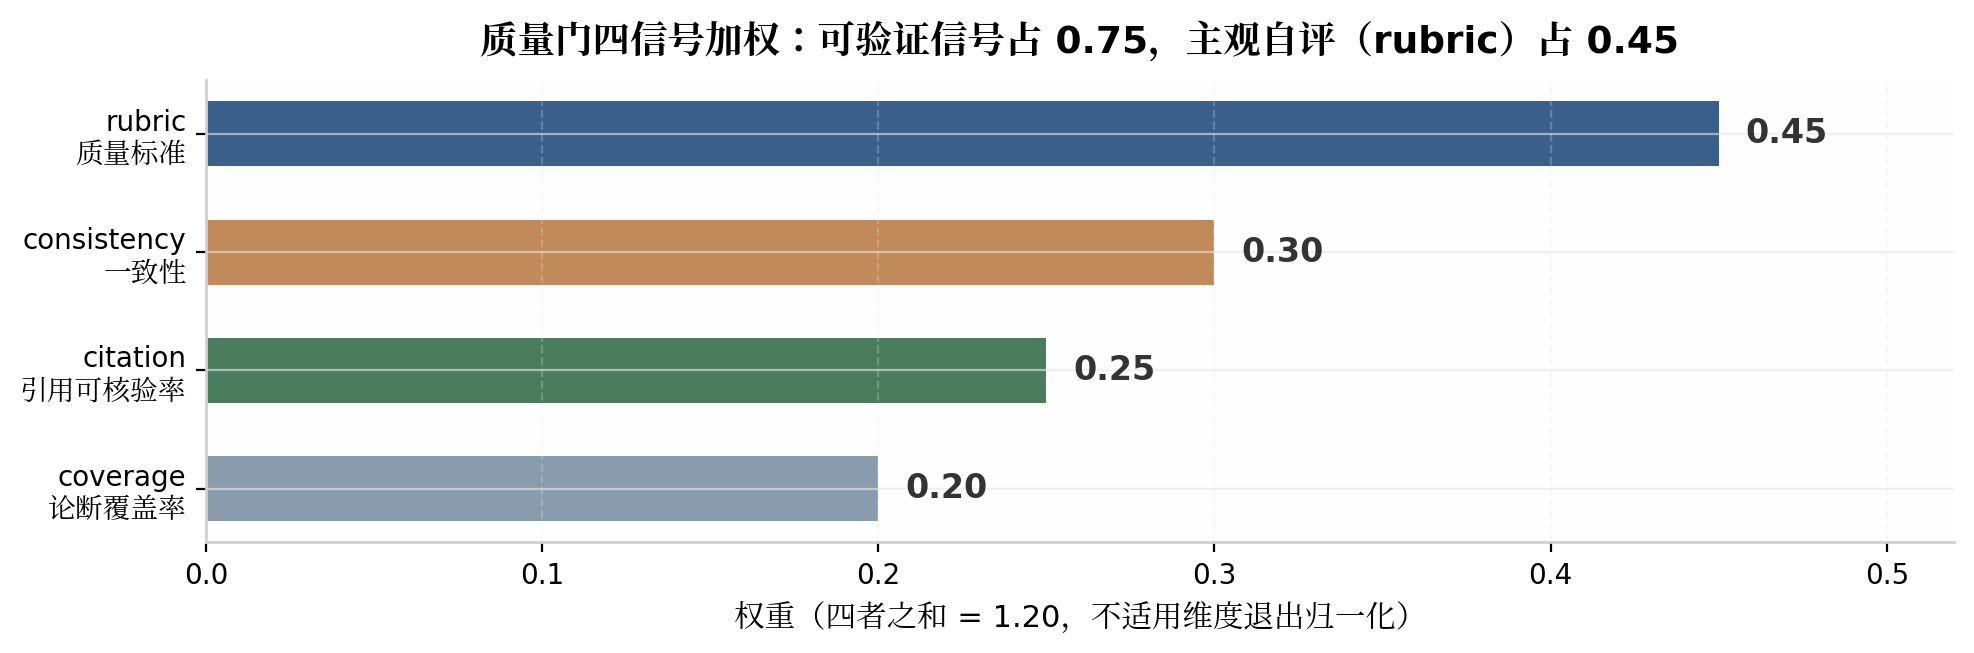
图:质量门四个可验证信号的权重分布。
放行判定
<!-- 若站点不支持公式渲染,替换为图片: -->
三个硬条件不参与加权打分,而是直接拦截:
- 冲突:起草员和复核员的结论存在结构性矛盾
- 数字不一致:合同中的期限/金额/比例与法规原文冲突(如"违约金不得超过合同总额的 30%",合同写了 50%)
- 尾部漏审:长合同(>20 条)的尾部条款成片未经复核覆盖
数字不一致的检查采用保守口径:只查禁止性边界("不得超过"、"最长"、"不低于"),不做逐字等值比对。宁可漏报不可误报——因为误报会让用户以为系统检查过了而放松警惕。
定向重跑
质量门未通过时,不是简单地说"重跑",而是生成一条定向改变指令(Directed Change),注入到重跑的 prompt 中。九种改变类型:
| 类型 | 触发条件 | 注入内容 |
|---|---|---|
| anti_hallucination | 引用了不存在的法条 | "仅据原文,禁止杜撰法条号" |
| enforce_citation | 论断无引用支撑 | "每个论断必须标注法条来源,或显式标注缺口" |
| resolve_conflict | 起草员与复核员结论矛盾 | 注入具体冲突点,要求裁决 |
| enforce_rubric | 质量标准未达标 | 未通过的标准作为硬性要求注入 |
| retry_missing | 步骤执行失败 | 重试失败步骤 |
| retry_uncovered_clauses | 长合同尾部漏审 | 定向重审未覆盖区段 |
| deepen_thinking | 推理深度不足 | 同档位拉长推导链重跑 |
| resolve_boundary | 数据边界无法核验 | 以已验证依据替代,或排除无法核验的主张 |
| none | 无可用改变 | 不空跑 |
铁律:每次重跑必须携带定向改变。不允许"原样重跑碰运气"——如果没有可用的改变(none),系统不触发重跑,而是直接进入终态决策。这条铁律防止了重跑循环空转浪费 token。
八、终态决策:三态信任分级
重跑有上限(通常 3 次)。耗尽后,系统面临一个现实问题:不达标就全盘拒答会让功能不可用,但无条件放行会输出不可信的结果。
ASEP 定义了三态终态:
| 终态 | 条件 | 交付形态 |
|---|---|---|
| passed | 质量门通过 | 正常交付,标记 [已核验] |
| escalate | 有可定位的硬缺口(法条编造、数字冲突、专家分歧) | 据实交付 + 标记 [需验证] + 提供人工复核入口 |
| best_effort | 未达标但拿不出具体缺口(rubric 自评低分等主观维度) | 按择优交付,标注置信度 |
关键设计决策:escalate 和 best_effort 的区别在于缺口是否可定位。
如果系统能明确指出"第三条引用的《公司法》第一百二十七条不存在"(可定位的硬缺口),那就 escalate——交付结果但标红这条,用户知道哪里需要人工复核。
如果系统只知道"整体质量评分 0.72,低于 0.8 阈值"(无法定位具体缺口),那就 best_effort——按当前最优结果交付,但标注置信度供用户自行判断。
这个分级避免了两个极端:(1) "不完美就拒答"导致功能不可用;(2) "不完美也硬推"导致用户误信不可靠的结论。
九、多场景应用:从合同起草到长卷宗阅卷
ASEP 不只是合同起草的协议——它作为统一数据总线贯穿了法律 AI 的全部核心场景。
多跳推理:LEAD CoT 从黑盒变白盒
一个交叉争议点的四跳推理,每一跳的置信度都被信封显式记录:
| 跳序 | 任务 | 置信度 | 事件 |
|---|---|---|---|
| Hop 1 | 事实认定 | 0.88 | 正常通过 |
| Hop 2 | 要件匹配 | 0.85 | 正常通过 |
| Hop 3 | 法条援引 | 0.82 | SRE 审查点:法条引用可核验 |
| Hop 4 | 后果推导 | 0.79 < 0.8 | 软熔断!回退 Hop 2,换新法条信封重推 |
Hop 4 置信度跌破 0.8 阈值时,系统不继续向下编——而是回退到 Hop 2,抽取新的法条信封,重新走 Hop 3 → Hop 4。重推后 conf=0.87,链路继续。
这与单模型的连续 CoT 有根本区别:单模型在第 4 跳置信度骤降时只能继续编下去(因为它没有步骤边界),而 ASEP 在第 4 跳熔断,错误不会进入最终结论。
长卷宗阅卷:300 页案卷 16 秒出结论
300 页卷宗 PDF 被切成 50 个 chunk,每个 chunk 封装为一个 ASEP 信封。5 路并发推理,每路每次只看 1 个 chunk + 上跳 metadata(不看其他 chunk 原文),设计目标墙钟 ~16 秒完成。SRE 收 50 个信封做一致性审查,输出争议焦点信封。
单模型方案需要把 300 页压缩截断后塞进一个 prompt,耗时显著更长且信息丢失不可控。ASEP 的上下文外置让每个推理步骤只看到它需要看的那 1 个 chunk,token 消耗降低的同时信息完整度反而更高。
以上数据来自 PPT 演示的设计目标,实际延迟随模型响应和卷宗复杂度浮动。
跨场景外延
ASEP 协议的设计是场景无关的,改场景不改协议:
| 场景 | 多 Agent 协同方式 |
|---|---|
| 律所尽调 | 多目标并行 Agent → 信封扇入(fan-in)→ 风险汇总信封 |
| 合同审查 | 条款识别 → RISK 信封(带 risk_level)→ DRAFT 信封(带 redline_diff 修订标记) |
| 合规监控 | RegWatch 订阅新法 → 信封(src_version=新)→ 差异比对 → 批量重审 |
| 涉外法律 | GDPR Agent / 数据法 Agent 各持 jurisdiction 信封 → 效力位阶跳转 |
这些场景共用同一套信封结构、同一套质量门、同一套熔断机制——这正是“协议级”抽象的价值:场景逻辑在协议之上实现,协议本身不需要为每个场景重写。
十、生产环境观察
延迟分布
一次完整的四 Agent 协作(合同起草场景),端到端延迟分布:
| 阶段 | p50 延迟 | 说明 |
|---|---|---|
| 意图路由 | ~45ms | 快速路径命中时无 LLM 调用 |
| 研究员 | ~2.5s | 含向量检索 + BM25 检索 + LLM 总结 |
| 分析师 | ~1.8s | 与研究员并行执行,取两者中最慢的 |
| 起草员 | ~8s | 20 条条款并发起草,温度 0.1 |
| 复核员 | ~3s | 交叉校验 + 质量门评估 |
| 定向重跑(若触发) | ~5s | 约 30% 的会话触发一次重跑 |
| 总计(无重跑) | ~14s | 研究员+分析师并行取 2.5s + 起草 8s + 复核 3s + 路由 45ms |
| 总计(含一次重跑) | ~19s | 用户体感:稍慢但结果更可靠 |
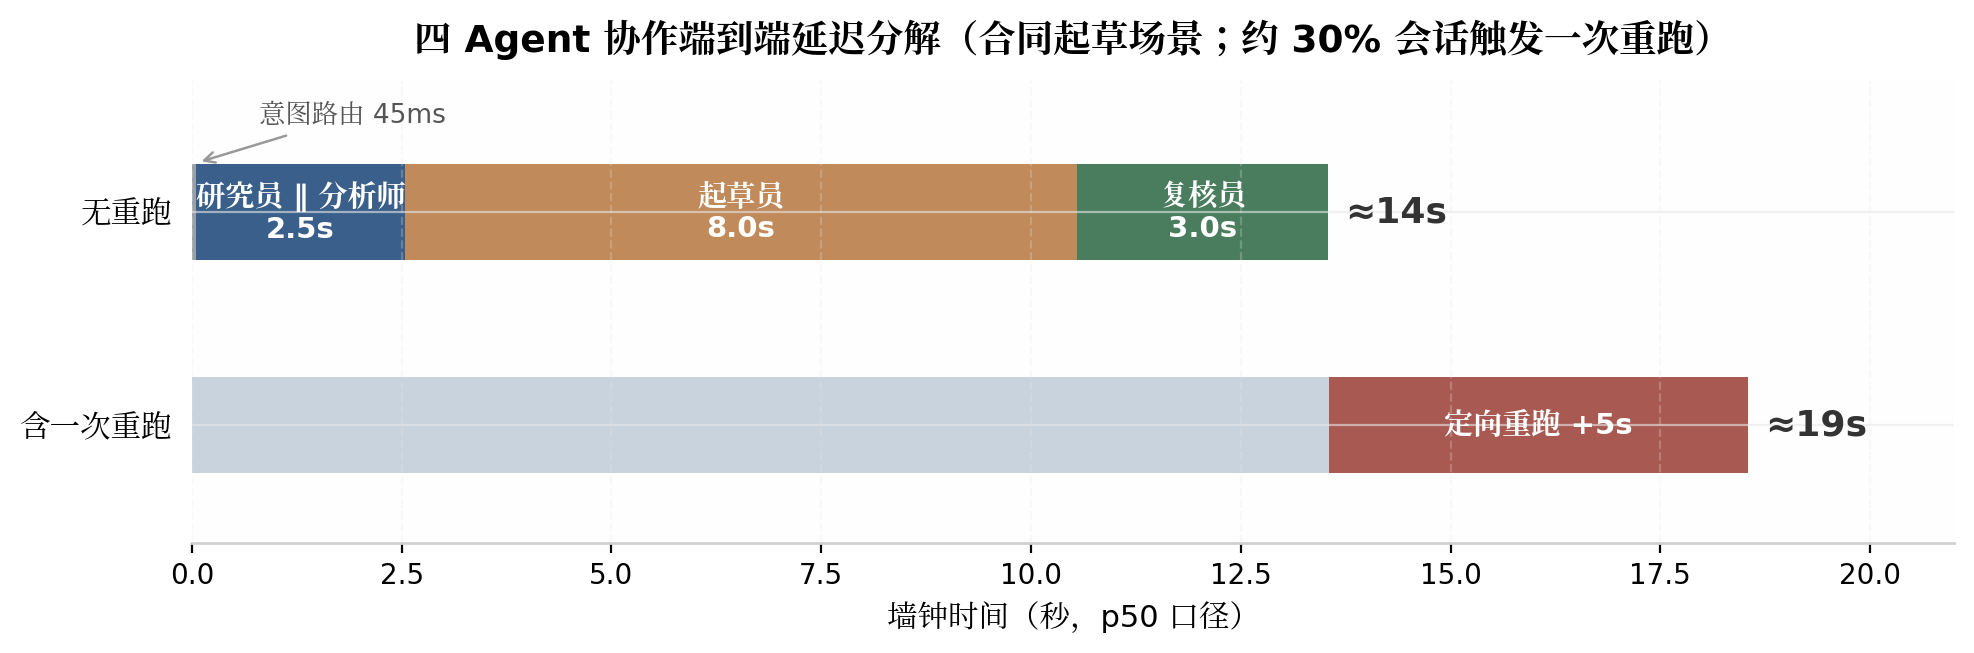
图:四 Agent 协作(合同起草场景)的端到端延迟分布。
质量门拦截率
在生产环境的合同起草场景中:
- 首次通过率:约 70%(质量门加权得分 ≥ 0.8 且无硬拦截条件)
- 一次重跑后通过率:约 90%(定向改变有效修复了大部分问题)
- 进入 escalate 态:约 8%(有可定位的硬缺口,如法条编造)
- 进入 best_effort 态:约 2%(主观维度不达标但无具体缺口)
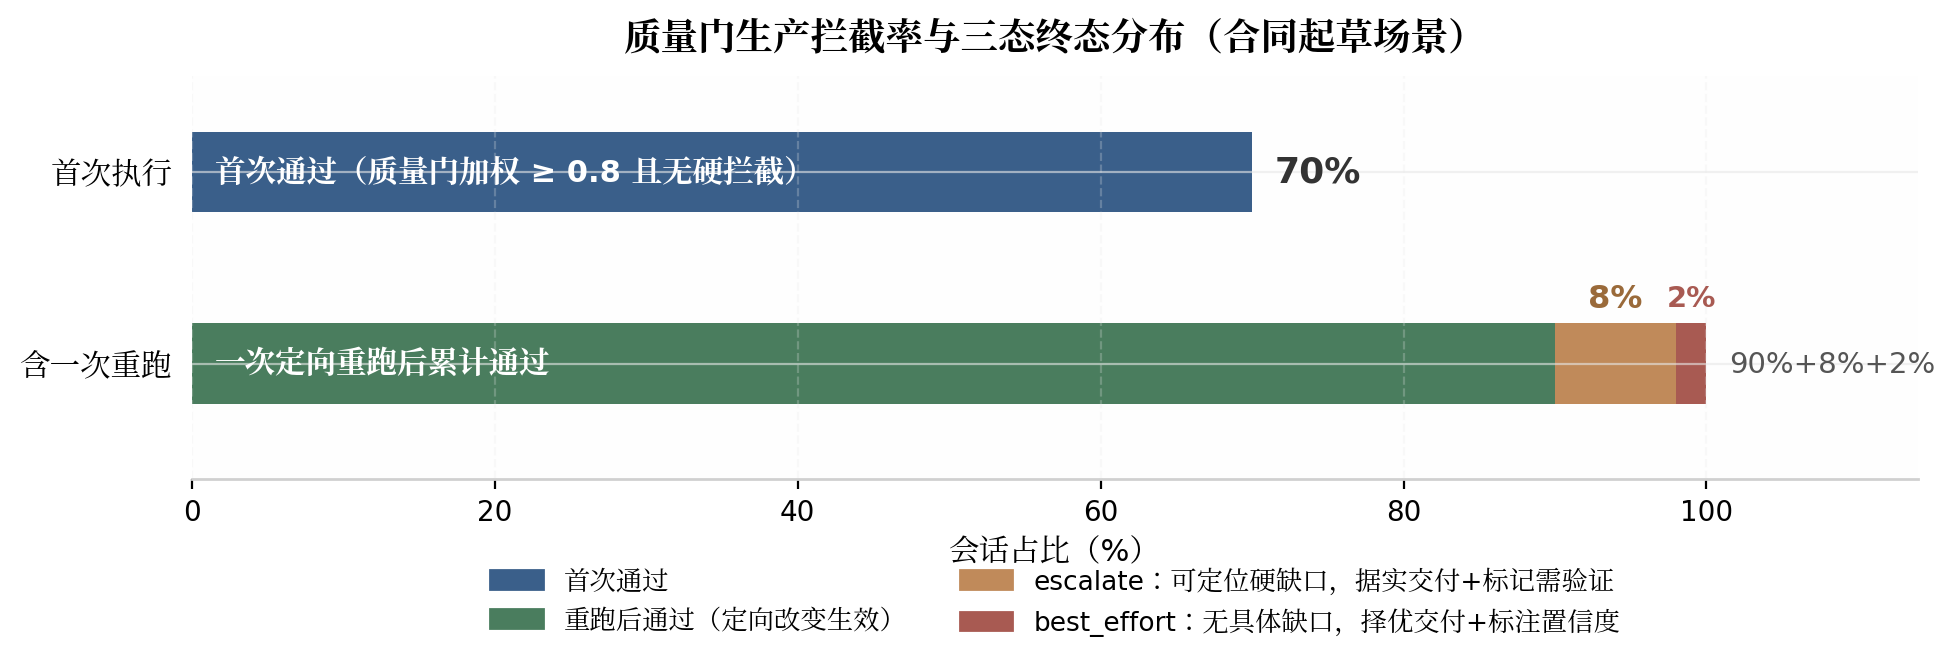
图:生产环境质量门的首次通过率、重跑修复率与终态分布。
最常见的触发重跑的信号是 citation(引用可核验率不足),占重跑触发的约 45%。这说明 LLM 在法律场景中最容易犯的错误是"编造看起来合理但实际不存在的法条号"——这正是质量门设计的核心防御目标。
熔断机制
当 LLM 服务不可用时,三级熔断保障系统不崩溃:
- L1:指数退避重试(最多 3 次,间隔 1s → 2s → 4s),处理瞬时故障
- L2:自动切换备用 Provider(按 fallbackOrder 依次尝试),处理单点故障
- L3:全部 Provider 失败,暂停等用户决策,不硬失败
错误信息被压缩为简短的、可回填 prompt 的上下文,让上层 Agent 据此尝试自愈——例如"模型 A 不可用,已降级到模型 B,请注意精度可能下降"。
十一、与同行方案的比较
MetaGPT (ICLR 2024 Oral):SOP 驱动的多 Agent 结构化通信。MetaGPT 定义了角色间的标准化消息格式(Message),但消息内容是自由文本——它解决了"谁在什么阶段跟谁通信"的问题,但没有解决"消息内容如何被机器路由和截断"的问题。ASEP 的信封在 MetaGPT 的 Message 之上加了一层骨架-载荷分离,使消息可截断、可校验。
LangGraph:基于图的 Agent 编排框架,步骤间传递 State 对象。State 是完全自定义的字典结构——灵活性极高但也意味着没有统一的"质量信号传递"机制。ASEP 的 confidence 字段和三级路由是在编排层之上叠加的质量感知层。
CrewAI:面向任务的多 Agent 框架,Agent 间通过 Task 传递结果。与 LangGraph 类似,传递的是自由文本结果,没有结构化信封。
DyLAN (AAAI 2025):动态 LLM Agent 网络,根据输入动态调整 Agent 间的连接权重。DyLAN 解决的是"哪些 Agent 应该参与"的问题,ASEP 解决的是"参与的 Agent 如何可靠地通信"——两者正交,理论上可以组合。
RLM (MIT CSAIL, 2025):将长文本放入 REPL 环境,模型通过代码生成自主递归分解子任务。RLM 的分解结构由模型代码动态生成(而非预定义),灵活性高但不可预测。ASEP 的分解是预定义的——由 DAG 工作流和范式库预定义结构。两者代表了多 Agent 协作的两条路线:动态生成式 vs 预定义结构化。在法律场景,我们选择预定义路线,因为法律输出的结构要求是刚性的(合同必须有特定条款、法条引用必须真实存在),不允许动态生成的不确定性。
我们的定位:不是提出新的多 Agent 编排算法,而是定义了一套适用于高精度领域(法律、医疗、金融)的 Agent 间结构化通信协议。增量贡献在于:(1) 骨架-载荷分离的可截断性;(2) confidence 驱动的三级路由;(3) 四信号加权的质量门与定向重跑;(4) 三态终态分级避免"不完美即拒答"。
十二、局限性
局限一:信封解析依赖 LLM 输出的结构可预测性。packEnvelope 从 Agent 原始输出中提取骨架元数据,这依赖输出格式的可预测性。如果 LLM 的输出格式严重偏离预期(如把 key_deliverables 写成了散文而非列表),信封解析会失败或产出不完整的骨架。目前没有对信封解析失败做专门的回退处理。
局限二:质量门的 rubric 信号仍是主观的。四个信号中,consistency、citation、coverage 都有客观的验证手段(交叉比对、查库、计数),但 rubric(权重最高的 0.45)来自 LLM 自评——它本质上还是"让 LLM 判断 LLM 的输出好不好"。这是一个有已知缺陷的信号:LLM 对自己的输出倾向于给高分。
局限三:范式库的维护成本。lawyer-verified 条款需要律师逐条审定,这是一个高成本的人工过程。目前范式库覆盖了常见的合同类型(劳动合同、软件开发、房屋租赁等),但对冷门法律关系(如海事合同、特许经营)覆盖不足。
局限四:DAG 工作流是静态的。当前的工作流结构在意图路由完成后就固定了,不会根据中间结果动态调整。如果分析师发现"这个 case 需要额外的合规审查",当前架构无法在运行时插入新步骤。DyLAN 的动态网络在这方面更灵活。
总结
| 设计决策 | 选择 | 解决什么问题 |
|---|---|---|
| 通信格式 | 骨架-载荷分离信封 | Agent 输出的可截断性和可路由性 |
| 截断策略 | 骨架不变性,载荷按预算截断 | 上下文爆炸,token 浪费 |
| 路由决策 | confidence 三级门控 | 质量问题在发生的环节被捕获 |
| 质量评估 | 四信号加权 + 硬条件拦截 | 可验证信号优先,主观信号兜底 |
| 修复策略 | 定向改变 + 禁止空跑 | 重跑循环空转,修复方向不确定 |
| 终态交付 | 三态分级(pass/escalate/best_effort) | "不完美即拒答"导致功能不可用 |
| 合同组装 | 纯函数骨架 + LLM 槽位填充 | 结构漂移 + 措辞偏差 |
| 容错 | 三级熔断 + 错误压缩回上下文 | 单点故障拖垮整条流水线 |
这套协议已经在生产环境支撑法律问答、合同起草、诉讼分析三大核心场景。它的设计哲学不是"让 Agent 更聪明",而是"让 Agent 的协作更可控"——在精度要求高的专业领域,可控性比创造性更重要。
参考文献
- Hong et al. "MetaGPT: Meta Programming for A Multi-Agent Collaborative Framework." ICLR 2024 Oral.
- Zhang, Kraska, Khattab et al. "Recursive Language Models." MIT CSAIL, arXiv:2512.24601, 2025.
- Liu et al. "DyLAN: Dynamic LLM-Agent Network: An LLM-Agent Collaboration Framework with Agent Team Optimization." AAAI 2025. arXiv:2310.02170.